这两天我看到一个叫 Jev 的 AI 模型。它来自 TypeSafe AI,是该公司公开的第一个 System One 模型。
它的入口带着一种反常识感。Jev 没有把聊天、内容生成和面向人的解释放在接口中心。开发者传入状态和 typed questions,再取回 Choice、Score 或 Noul 结果,供软件直接分支、排序和路由。
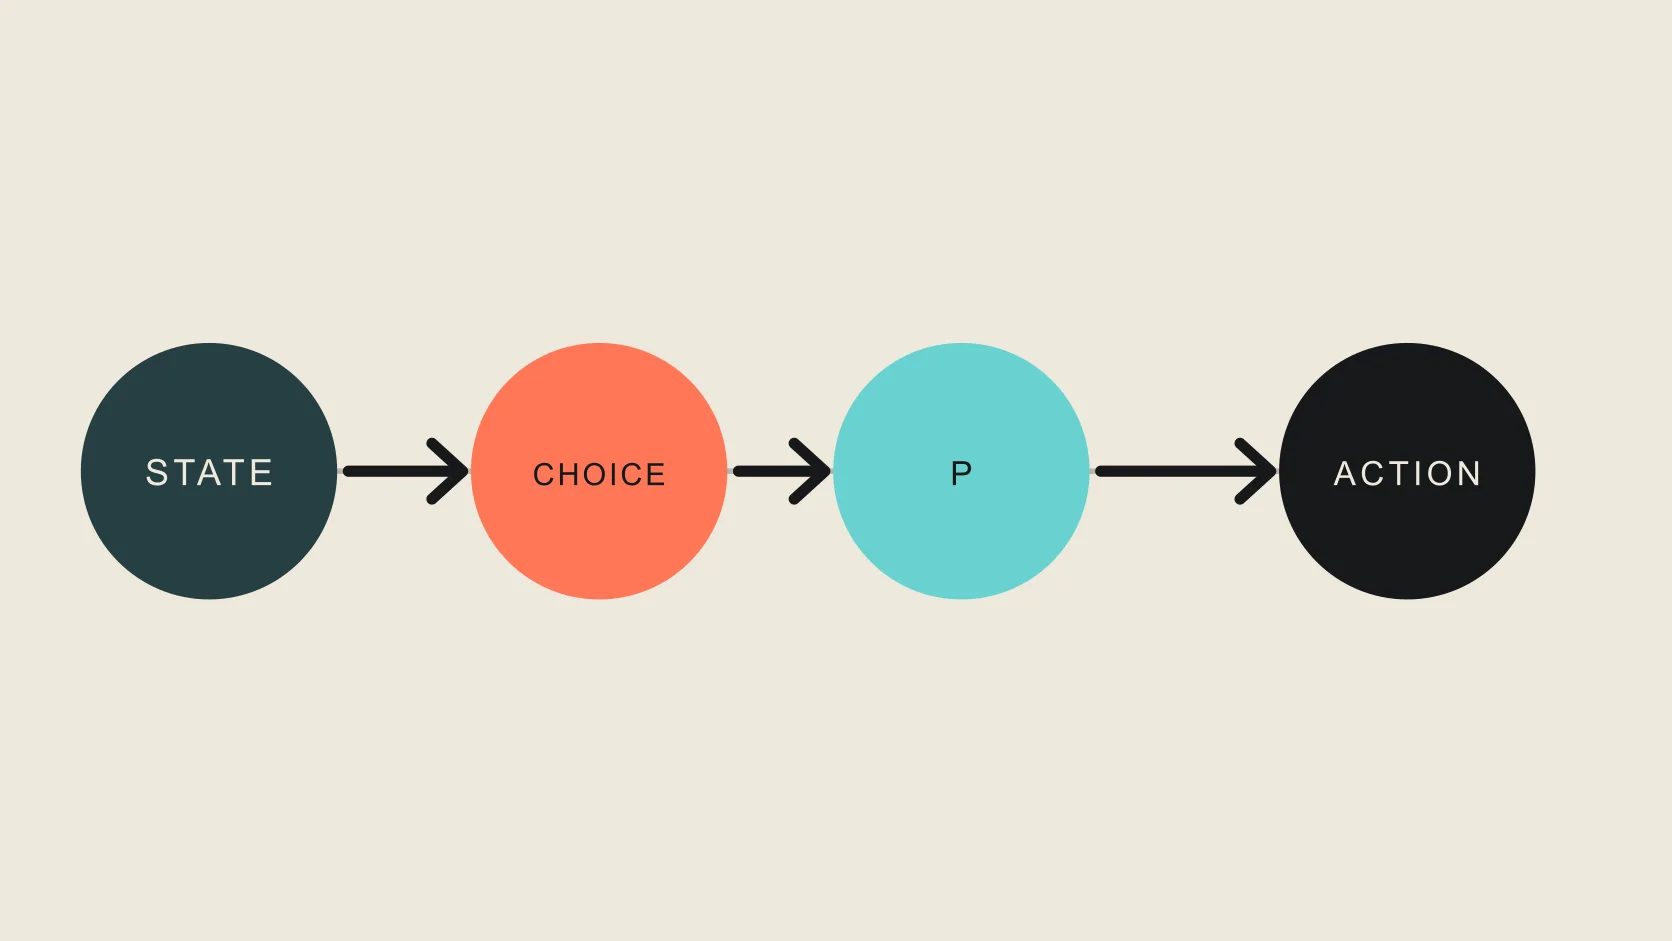
我首先想到的是:光说做决策,很多模型都能做到。Jev 为什么会被拿出来讨论?我随后去看了它的延迟、训练目标、正确率问题和可能的应用方式。
低延迟只是第一层
TypeSafe 在发布文中给出 70 到 500 毫秒的端到端响应范围,并把并行采样、结构化输出和新的模型架构放在同一套自动化栈里。
我一开始想不起那个 R 开头的训练方法。它叫 RLCD,Reinforcement Learning for Calibrated Decisions。TypeSafe 对它的解释是:训练模型返回决策和校准概率,使用者可以根据不确定程度决定继续执行、升级处理或请求人工复核。
这就带出低延迟模型最难绕开的一个问题:它快速给出答案时,凭什么让软件相信它?
TypeSafe 把校准解释为一组预测的统计关系。若大量预测都给出 0.8,长期结果应该接近八成正确。Choice 与 Score 有概率分布和 confidence,Noul 返回 0 到 1 的值。它们提供不确定性信号,阈值和风险由应用代码决定。
我用人的直觉理解它
我想到一个很生活化的场景。
你在路上走,一辆车开得很快,眼看就要撞上来。你不会先在脑子里计算距离、速度和到达时间,再决定要不要躲。身体先给出一个判断:危险,赶紧离开。
我踢球时也遇到过类似的事。一个人反复见过很多场景,认真复盘过不同处理方式,也做过足够多的专项训练,球到了脚下,动作就可能更快。这个动作看起来像直觉,背后压着的是样本、经验和训练。
TypeSafe 把 System One 的命名和《思考,快与慢》中的快速、直觉式 System 1 联系起来。这个名字指向 Jev 要处理的判断类型。
Agent 的中间态可以直接交给机器
这一步让我想到一个更大的问题。
今天很多语言模型的输出首先面向人。模型生成文字,人阅读文字,系统再根据文字安排下一步。Agent 系统内部却有大量不会展示给人的中间态:路由、判断、状态更新、动作选择和风险分级。
这些中间态可以写成:状态 → 判断 → 人类可读文本 → 程序解析 → 动作。
也可以直接写成:状态 → Choice / Score / Probability → 动作。
我这里讨论的是交接格式:机器之间的某些交接,可以跳过为人生成自然语言的步骤。
这可能提高内部循环的效率,也可能减少一次转换造成的误读。是否真的更快、更准,要由同一任务上的对照测试回答。
AI 导播让我把这个问题落到项目上
前两天我曾经 YY 过一个游戏 AI 导播。
最初我按人类观看比赛的方式去设计:让系统看到屏幕,通过多模态识别或抽帧理解发生了什么,再把结果交给导播台,自动决定给谁镜头。
后来我想到,游戏本来就是数字系统。引擎已经掌握玩家位置、血量、装备、经济、射击、命中和击杀等事件。只要提供一个能稳定读取这些状态的接口,AI 可以直接判断谁更值得看,哪里可能马上发生交火,当前镜头是否还保留信息价值。
这个想法在我看到 Jev 后突然连上了。Jev 适合承担机器中间态的窄判断,导播系统负责把多个判断组合成镜头策略和动作。
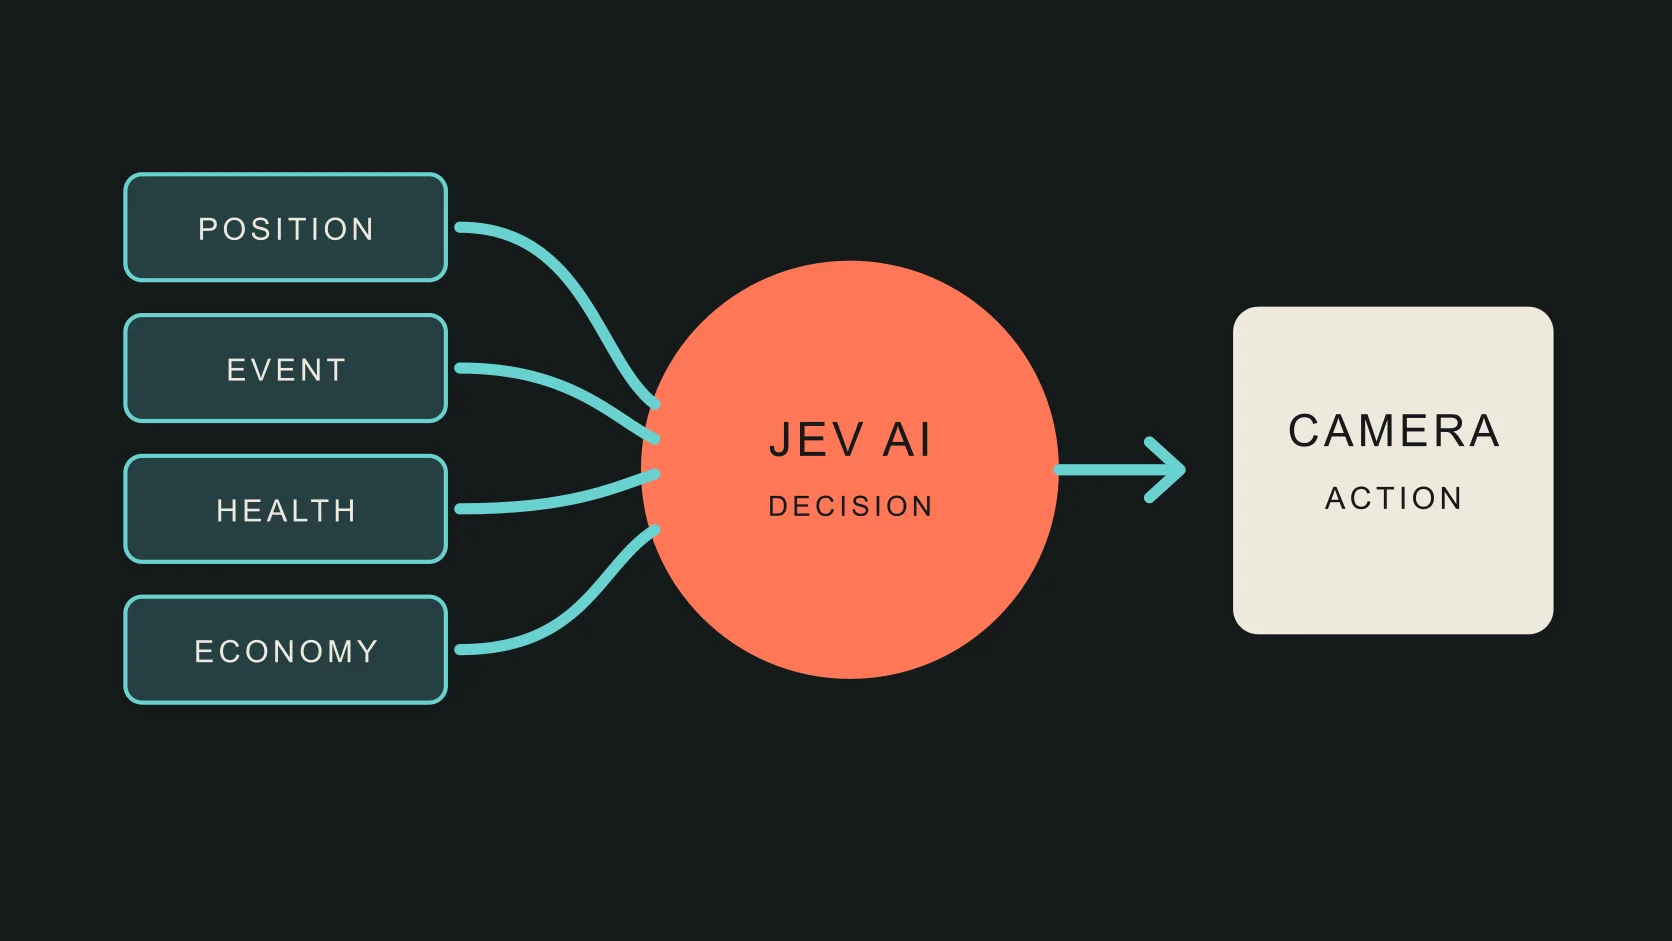
如果把 Jev 接进这个项目,我会先测试几个范围很窄的问题:谁值得拿镜头、哪里可能马上交火、当前镜头是否还保留信息价值。
这个问题在我自己的项目里也出现了
前面提到的 FLG,就是我自己正在做的 FlowGrid 项目。它里面有一套项目决策记录,AI 会参与记录和维护项目推进中的状态、判断与变化,人需要复盘时再把这些记录调出来看。
我曾经以为,决策日志主要给自己看。项目推进时,AI 记录判断;项目中途或接近结束时,我回来回顾关键分叉。
几个月的实际使用给了我一个不同的观察:我很少主动翻它,更多时候是 AI 在读取和维护。人的阅读集中在复盘时刻,问题也很具体:项目怎么长出来,哪些信息改变了方向,哪些判断后来失效。
这让一个候选方向浮现出来。日常工作需要的可能是机器状态,人的日志、摘要和复盘是这些状态面向人的视图。机器状态至少需要保留当前判断、依据、变化和未决分歧,并能回到来源。
这套分层会保留当前判断、依据、变化和未决分歧,并能回到来源。
我们后来把它跑了一轮
拿到更完整的测试结果后,我们把问题拆开跑了一轮。我们拿 12 条脱敏的 FLG 决策,构造 48 个事件。每条决策各放一个支持、挑战、无关和信息不足的例子。每个事件再拆成四个独立的 Noul,分别判断它是否挑战原决策、是否与原决策一致、是否无关,以及当前上下文够不够做正式判断。
先做的 8 个事件组合对照中,四类关系揉成一个判断时命中 4/8;拆开关系信号和上下文充分度后,关系判断命中 8/8。扩大到 48 个事件后,关系判断 48/48,动作映射也是 48/48。挑战事件进入负责人复核,一致证据保留为候选,无关事件停止传播,信息不足继续保持候选状态。
这次拆分给了我一个很具体的提醒。上下文充分度低,可以阻止正式晋升,却不该抹掉高风险的挑战信号。Jev 负责语义判断,FLG 负责关系传播、状态写入和负责人复核,两个层次各自保留清楚。
真实 FLG 脱敏决策摘录的测试分四批完成,总耗时 6.883 秒,输入 43,897 tokens,输出 5,056 tokens。另有一组完全合成的 Choice 对照,48/48,只用于确认 Choice 原语,没有发送 FLG 私有材料。这个耗时包含远程网络和批处理,不能直接和本地 FLG 的关系传播速度比较。
这次是诊断测试。48 个事件和预期标签由 Codex 根据决策文本构造,没有独立人工真值。正式 FLG 账本没有写入,隔离副本的 status、context、impact 检查通过。下一步需要用真实历史证据做双人盲标,再统计每类漏报和置信度校准。
Jev 目前对我最大的价值,来自它提供的这个问题:软件内部是否可以直接交换状态和判断,把语言留给提问、解释、纠正和授权?
我下一步更愿意做一个小实验。让 AI 只依据当前状态接手一段导播项目,检查它是否能继承有效信息;再让它解释一次镜头策略变化,逐条回到原始依据。这个结果会比一段漂亮的产品叙述更有用。